Dans l’article d’aujourd’hui, nous allons voir comment installer et utiliser Tesseract pour reconnaitre des caractères dans une image.
Commençons par un peu d’Histoire, Tesseract est un projet initialement développé par Hewlett Packard entre 1985 et 1994 puis mis de côté pendant une dizaine d’années. C’est en 2005 que le code source est finalement libéré sous licence Apache, et il est maintenu depuis 2006 par des équipes de Google.
Pour ce qui est de son fonctionnement, Tesseract utilise les réseaux de neurones pour reconnaitre les caractères et les mots.
Aujourd’hui Tesseract prend en charge une centaine de langages différents, est Open Source et fonctionne avec la plupart des systèmes d’exploitation.
Installer de Tesseract
Afin de pouvoir utiliser la librairie Tesseract, il est nécessaire de l’installer sur notre machine.
Pour les utilisateurs de MacOS, l’installation se fera grâce à Homebrew.
brew install tesseract
Si vous utilisez Debian ou Ubuntu, Tesseract peut être obtenue par apt-get:
sudo apt install tesseract-ocr
Enfin, pour les utilisateurs Windows, vous pouvez trouver un installateur sur le GitHub de la bibliothèque universitaire de Mannheim. Une fois l’installation terminée, vous obtiendrez un raccourci « console » dans le dossier tesseract-OCR du menu démarrer.
C’est fait, Tesseract est installé.
Analyser une image
Afin d’obtenir de bons résultats avec la reconnaissance de caractère de Tesseract, il faut que l’image que l’on donne en entrée contienne un texte clair, net et précis. En d’autre termes, il faut une image avec la plus grande résolution et dpi possible et que le texte soit facilement séparable du fond.
Testons avec cette image:
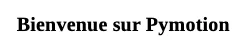
tesseract test_tesseract.jpg stdout
Le résultat donne
Bienvenue sur Pymotion
D’accord il ne s’agit que de 20 lettres, essayons donc avec un texte plus grand Le résultat est toujours au rendez vous:
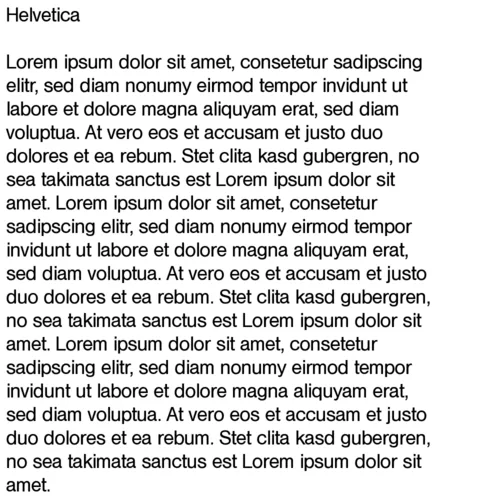
Helvetica

Lorem ipsum dolor sit amet, consetetur sadipscing
elitr, sed diam nonumy eirmod tempor invidunt ut
labore et dolore magna aliquyam erat, sed diam
voluptua. At vero eos et accusam et justo duo
dolores et ea rebum. Stet clita kasd gubergren, no
sea takimata sanctus est Lorem ipsum dolor sit
amet. Lorem ipsum dolor sit amet, consetetur
sadipscing elitr, sed diam nonumy eirmod tempor
invidunt ut labore et dolore magna aliquyam erat,
sed diam voluptua. At vero eos et accusam et justo
duo dolores et ea rebum. Stet clita kasd gubergren,
no sea takimata sanctus est Lorem ipsum dolor sit
amet. Lorem ipsum dolor sit amet, consetetur
sadipscing elitr, sed diam nonumy eirmod tempor
invidunt ut labore et dolore magna aliquyam erat,
sed diam voluptua. At vero eos et accusam et justo
duo dolores et ea rebum. Stet clita kasd gubergren,
no sea takimata sanctus est Lorem ipsum dolor sit
amet.
C’est super ça marche!
Pas tant que ça, il y a quand même certaines limites !
Reprenons notre image initiale et ajoutons une barre grise en oblique.
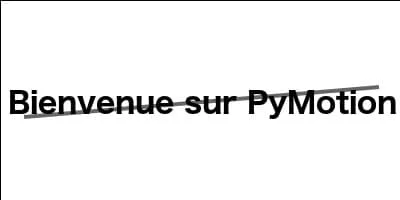
Un humain reconnaîtra sans problème les lettres et mots écrits. Tesseract non.

En effet, une simple barre permet de dérouter Tesseract. Comme je vous l’avais mentionné avant, il faut que le texte soit facilement séparable. Cependant à force de venir sur ce site, il vous est simple de trouver une solution à ce problème. Nous verrons la semaine prochaine comment interfacer tesseract avec Python afin que vous puissiez créer de superbes applications de reconnaissance de texte.
Pour conclure, Tesseract est un très bon outil pour extraire un texte d’une image. Au fur et à mesure du temps l’outil est devenu de plus en plus performant et il est dorénavant possible de spécifier le langage afin d’obtenir de meilleurs résultats. Cependant dès lors que le texte n’est pas clairement identifiable, il est nécessaire d’appliquer des prétraitements à l’image afin de pouvoir décoder les caractères.